16 de octubre de 2026
El Gran Cierre: el acuerdo que fundó Internet acaba de romperse

Durante casi treinta años, tú, yo y cualquier creador de contenido jugamos bajo las mismas reglas de un pacto invisible pero sagrado: nosotros escribíamos, diseñábamos o programábamos gratis para la red, y a cambio, los buscadores nos indexaban y nos enviaban visitas. Este intercambio simbiótico alimentó la época dorada de la web abierta. Los creadores consiguiendo visibilidad, comunidad e ingresos publicitarios; los usuarios encontrando respuestas; y los buscadores convirtiéndose en gigantes multimillonarios organizando la información del mundo.
Hoy, ese pacto ha saltado por los aires. Hemos pasado de la simbiosis a la extracción pura.
1. El asedio de las máquinas: De "páginas visitadas" a "respuestas generadas"
La llegada de la Inteligencia Artificial Generativa y la voracidad de los nuevos modelos de lenguaje han transformado las reglas del juego. Los motores de búsqueda ya no quieren ser un mapa que te dice dónde ir; quieren ser el destino final.
Cuando buscas algo, la IA consume el contenido original de un creador, lo procesa, hace un resumen en su propia interfaz y te lo entrega masticado. La visita al sitio web original nunca llega a producirse.
La cruda realidad en números
- Adiós al clic: Los datos confirman que el uso de resúmenes de IA en buscadores reduce los clics en los resultados tradicionales a casi la mitad (del 15% al 8%). De hecho, los enlaces incluidos dentro de esos resúmenes apenas reciben un 1% de atención.
- Costes de servidores insostenibles: Un creador denunció recientemente que un solo bot de IA descargó 73 TB de datos de su web de documentación en un solo mes, generándole una factura de 5.000 dólares en concepto de ancho de banda. Los creadores no solo se quedan sin visitas, sino que además tienen que pagar la factura de la luz de quienes los "saquean".
2. La magnitud del saqueo en cifras
El comportamiento de los nuevos rastreadores (crawlers) de IA roza el abuso de infraestructura y, a menudo, es técnicamente indistinguible de un ataque de Denegación de Servicio (DDoS).
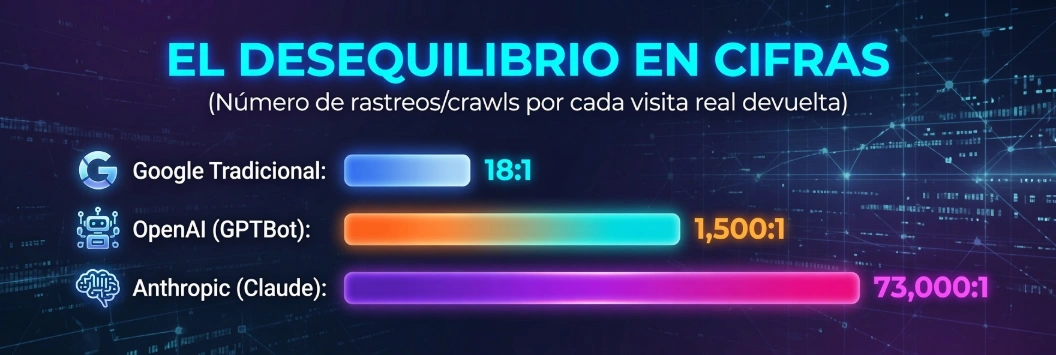
Para entender la escala del problema, firmas de infraestructura como Cloudflare han analizado el desequilibrio entre las páginas que las IA "leen" frente a las visitas que devuelven a los creadores: Mientras que el buscador tradicional de Google mantiene un flujo de retorno razonable, bots como el de Anthropic llegan a devorar decenas de miles de páginas web sin enviar prácticamente un solo usuario real de vuelta a la fuente.
3. Un Internet colonizado por bots: ¿Hacia el "Internet Muerto"?
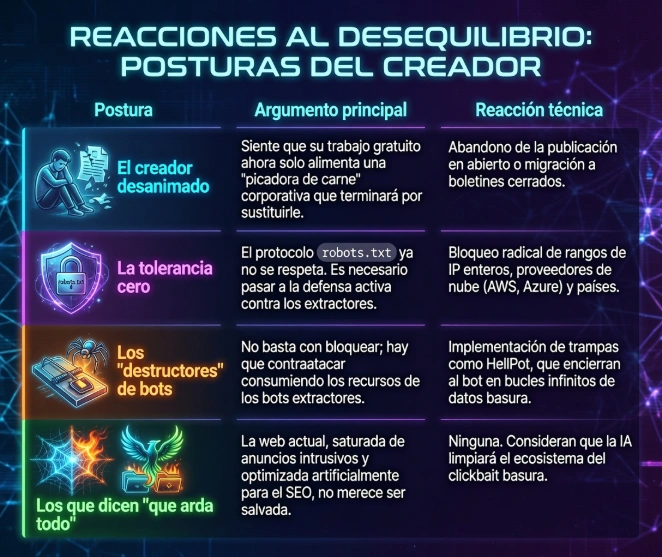
El debate en foros especializados (como Hacker News o LWN) y comunidades de creadores oscila entre la rabia, el pragmatismo y el cansancio. Los últimos informes de ciberseguridad revelan una realidad alarmante: por primera vez, el tráfico de bots (51%) supera al tráfico humano (49%), con más de un 37% de "bots malos" dedicados al fraude y al scraping masivo.
Además, se estima que más del 52% del contenido nuevo en la web es ya generado por IA, creando un bucle cerrado donde las máquinas se entrenan con textos de otras máquinas. Ante este escenario, la comunidad digital se divide en cuatro corrientes claras:
4. "The Great Scrape": El vacío legal y la pérdida de privacidad
Expertos en leyes y privacidad de datos definen esta era como "El Gran Saqueo" (The Great Scrape). Sostienen que el rastreo masivo e indiscriminado de datos de personas reales no es solo un problema de propiedad intelectual, sino una forma de vigilancia sistémica.
El scraping masivo ignora por completo principios básicos de privacidad como la minimización de datos, el consentimiento previo y la transparencia. Para colmo, las leyes actuales (como la CFAA en EE.UU.) se centran en el daño a la propiedad del servidor y no protegen a los individuos cuyos datos personales son cosechados.
Para evadir los bloqueos técnicos, muchos bots utilizan redes de proxies residenciales. Compañías de scraping compran ancho de banda a usuarios particulares para enrutar sus bots a través de direcciones IP de hogares reales, haciendo que el tráfico de extracción sea indistinguible de la visita de un usuario legítimo.
5. La contraofensiva: Cloudflare, ProRata AI y el código HTTP 402
Ante la ineficacia de los métodos tradicionales, líderes del sector están impulsando soluciones técnicas y comerciales para restablecer el equilibrio de poder.
La iniciativa más agresiva viene de la mano de Cloudflare, la red de distribución de contenido que protege aproximadamente al 20% de las webs del planeta. Su CEO, Matthew Prince, y su directora de estrategia, Stephanie Cohen, han dejado claro que el objetivo no es destruir la IA, sino obligar a las tecnológicas a jugar limpio mediante dos grandes estrategias:
A. Bloqueo por defecto y declaración de intenciones
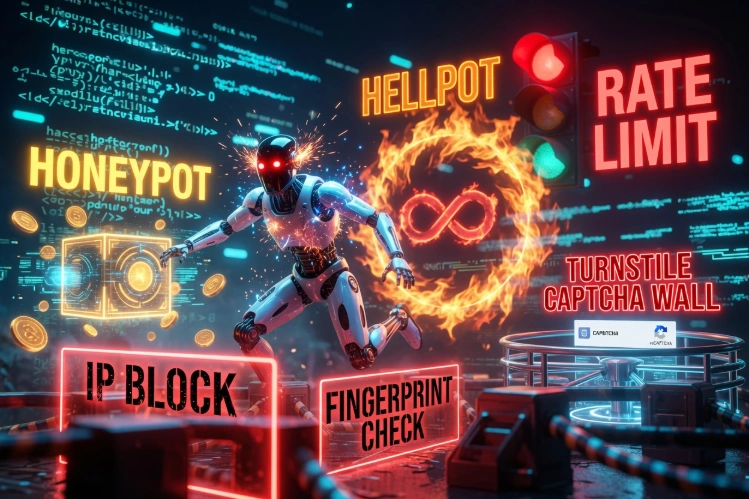
Cloudflare permite ahora a los administradores bloquear por defecto a cualquier rastreador de "uso mixto". Si una empresa de IA quiere acceder, debe declarar con total transparencia si su bot busca indexar contenido (para enviar visitas de vuelta) o únicamente "entrenar" a su modelo (para absorber datos).
B. El despertar del código HTTP 402 (Pay-per-Crawl)
A través de este protocolo, si un bot de entrenamiento quiere saltarse el bloqueo y leer tu artículo, el servidor le frena en seco y le responde con un error HTTP 402 "Payment Required". El propietario de la web establece un micro-precio automatizado por consulta (por ejemplo, $0.01) y, si la IA quiere la información, debe realizar un micropago instantáneo utilizando firmas criptográficas antes de poder leer el código de la página.
El modelo alternativo: Pay-per-Use
Mientras Cloudflare apuesta por cobrar por el derecho a leer (Pay-per-Crawl), otras plataformas como ProRata AI defienden que el pago debe realizarse únicamente cuando el contenido de un creador es seleccionado para responder al usuario (Pay-per-Use), repartiendo hasta el 50% de los ingresos de esa consulta con el autor original.
¿Hacia dónde se encamina la web humana?
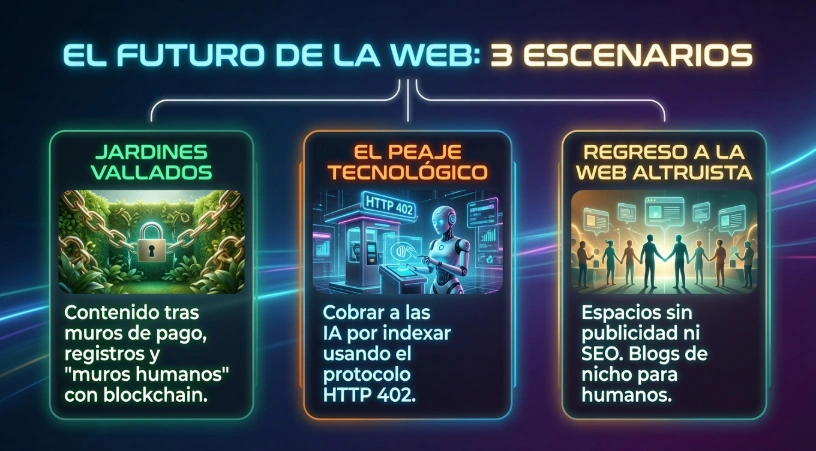
El ecosistema digital se encamina de forma inevitable hacia una fragmentación que cambiará nuestra forma de usar Internet:
- La era de los "Jardines Vallados": Para protegerse de la extracción masiva, la web de calidad se esconderá. Veremos un auge de foros privados, comunidades accesibles solo por invitación o verificación de identidad humana, y contenido tras muros de registro obligatorio.
- El retorno a la web romántica: Sin el incentivo del tráfico masivo para ganar dinero con publicidad, los incentivos para crear clickbait desaparecerán. Esto podría dejar en pie únicamente los blogs personales y proyectos comunitarios de personas que escriben por el mero placer de conectar con otros humanos.
La era en la que podías abrir un navegador y acceder instantáneamente a cualquier conocimiento del mundo de forma libre, gratuita y sin barreras está llegando a su fin. Si las máquinas quieren seguir alimentándose de la creatividad humana, tendrán que empezar a pagar el precio de la entrada. De lo contrario, acabarán atrapadas en un desierto digital, alimentándose únicamente de sus propios textos generados en un Internet sin humanos.
Comentarios (1)
Rastrear datos irrelevantes e innecesarios en todas las webs para agregarlos y venderlos con fines de marketing es muy diferente, molesto y básicamente la razón por la que internet apesta hoy en día
Deja un comentario
Tu comentario será revisado antes de publicarse.